近日,计算机系高性能所翟季冬教授团队的研究成果“八卦炉2:弹性激活驱动的高效混合专家大模型训练系统”获评2026中国算力大会最佳学术论文。论文第一作者为计算机系博士生翟明书,通讯作者为翟季冬,北京科技大学副教授宗瓒,计算机系助理研究员金煜阳。
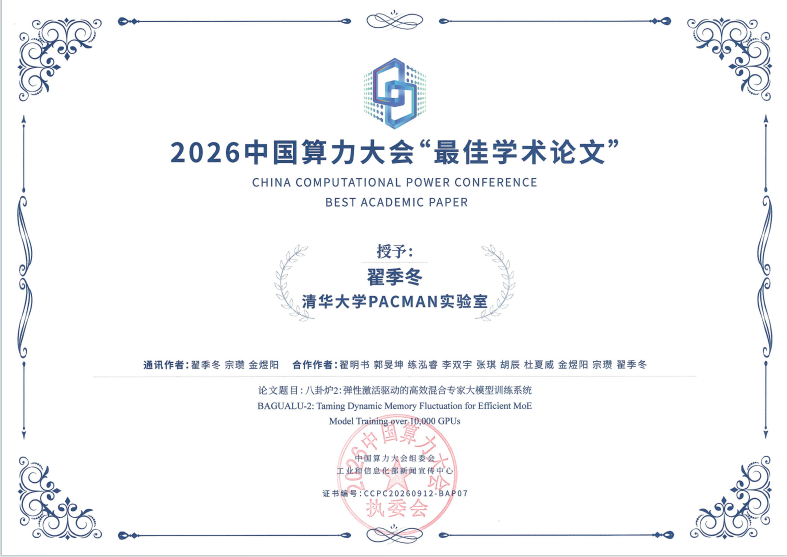
2026中国算力大会最佳学术论文获奖证书
混合专家模型(Mixture-of-Experts,简称MoE)通过感知输入动态选择并激活部分专家参与计算,在控制计算开销的同时扩大模型容量。然而,在训练过程中,不同专家被分配到的任务量会随输入而变化,短时间内出现负载不均,部分设备上的激活数据可能迅速增加,造成显存溢出和训练中断。现有训练系统通常采用在任务启动前固定显存管理策略:为负载尖峰预留较多空间,会显著增加正常训练时的额外开销;如果减少预留空间,又容易在尖峰出现时触发系统故障。在万卡规模下,这一问题直接影响训练效率与稳定性。
针对上述问题,研究团队提出弹性激活管理方法,将显存管理从训练前的静态配置转变为训练过程中的逐批次动态调整。系统结合流水线执行状态与专家实际负载,估算当前批次的激活显存需求,按需选择重新计算中间结果,或将其临时转移到主机内存,在控制显存峰值的同时减少额外开销。团队进一步设计双批次融合执行机制,交错调度相邻批次的计算与数据传输,利用硬件空闲时段完成显存管理操作,提高整体效率。
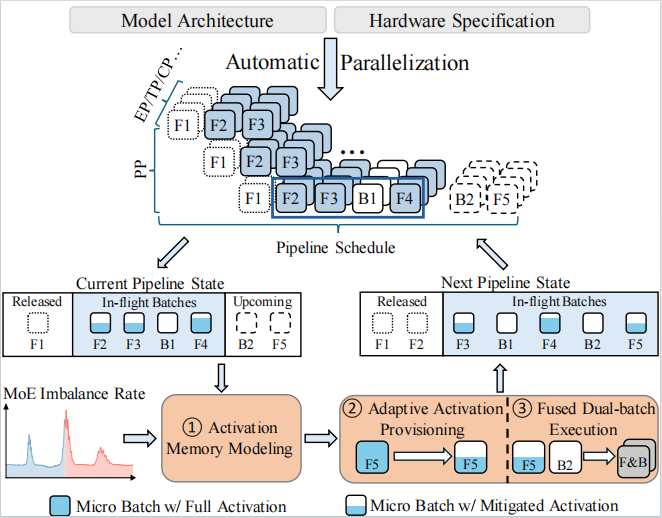
八卦炉2系统架构:根据流水线状态与专家负载,动态完成激活显存建模、弹性激活管理和双批次融合执行
研究团队在曙光8000集群上进行验证,使用12,288张海光DCU加速卡完成超过1.04万亿参数MoE模型的训练验证,总计算吞吐达到2.012 EFLOPS。在128至12,288张加速卡的多组配置下,八卦炉2能显著提升典型开源MoE大模型的训练效率。实验表明,该方法能够适应专家负载变化,在万卡规模上兼顾训练稳定性与计算效率,为国产算力平台上的大规模模型训练提供系统软件支持。
中国算力大会由工业和信息化部等部门与地方政府联合主办,是我国首个以数据中心算力赋能为主题的省部联办会议。大会面向通用算力、高性能算力、智能计算、算力应用及算力基础设施等领域,关注相关基础理论和应用研究中的创新成果。